Företagare vill veta så mycket som möjligt om användarbeteende i en eller flera applikationer eller ha en uppsättning rapporter som ger en tydlig bild av användarengagemang och kundlojalitet, de aktiviteter som ger information som är viktig för att planera nya funktioner eller förbereda en presentation för investerare.
Den här artikeln förklarar hur man extraherar insamlade användaråtgärder från Mixpanel och Segment till AWS S3-bucket(er), hur man konfigurerar Mixpanel/Segment-pipelines och senare hur man frågar efter extraherad data i Redshift. Vad den här artikeln inte kommer att täcka är konfiguration av Mixpanel/Segment-spårning och konfiguration av Redshift-kluster eftersom dokumentationen är självförklarande.
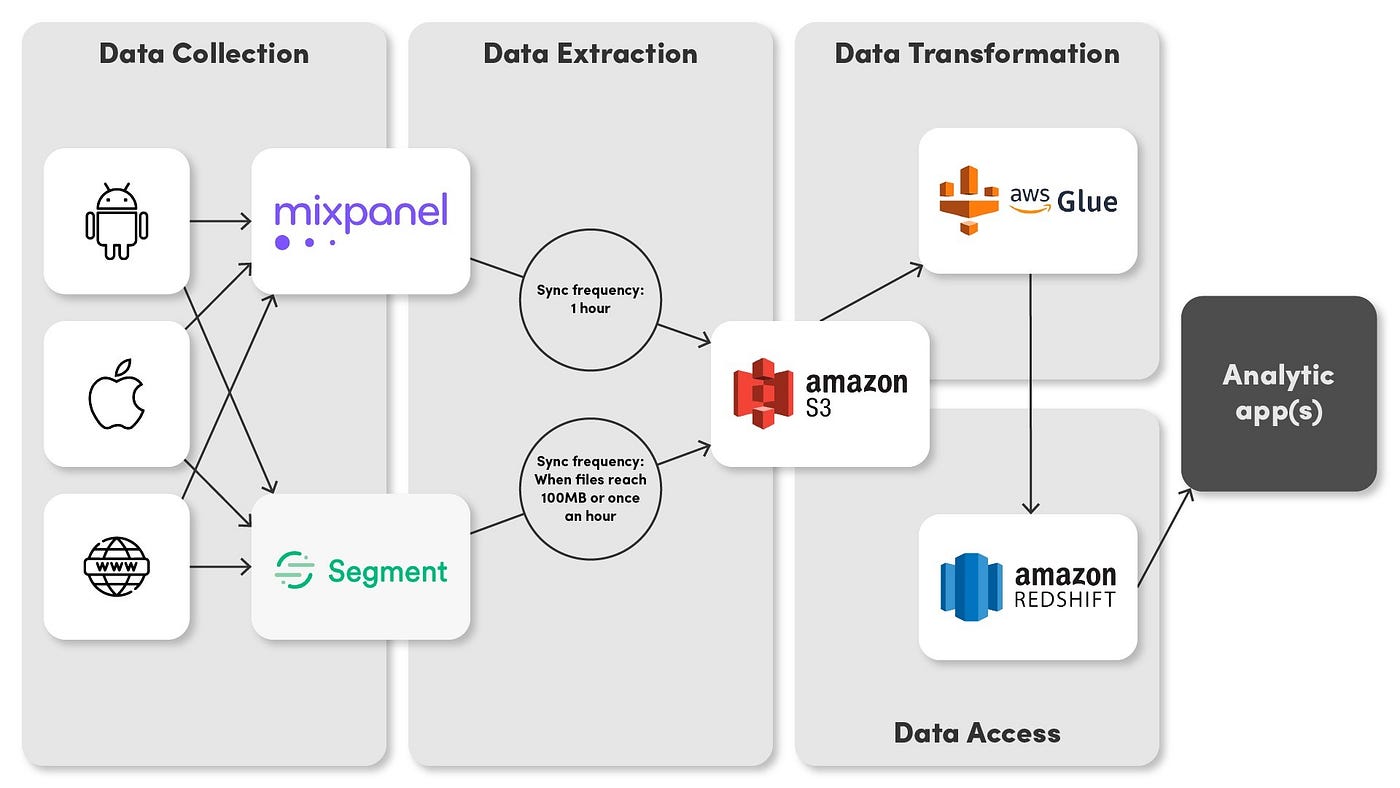
Det första steget är att definiera användaråtgärder som ska spåras. Låt oss föreställa oss att vi har en mobilapplikation som är ett index över alla börsnoterade företag i ett land och slutanvändaren kan följa några av dem och kontrollera deras insikter och månadsrapporter. I det här användningsfallet är en av de användaraktiviteter som kan övervakas den åtgärd som följs, därför bör varje klick på knappen Följ i applikationen spåras. Förutom klick måste vi veta vilket företag som följs och från vilken applikationsskärm.

För att spåra användaråtgärder kan vi använda olika tredjepartstjänster som Mixpanel ( https://mixpanel.com/ ) eller Segment ( https://segment.com/ ).
Bilden ovan illustrerar en samling anpassad information som kommer att användas för spårning av efterföljande åtgärder. Förutom anpassad metadata kan alla tredjepartstjänster automatiskt övervaka vissa vanliga användardata, såsom enhetsinformation, operativsysteminformation, användarens plats och så vidare.
Här är ett exempel på Mixpanel-egenskaper som är kopplade till varje spårhändelse:
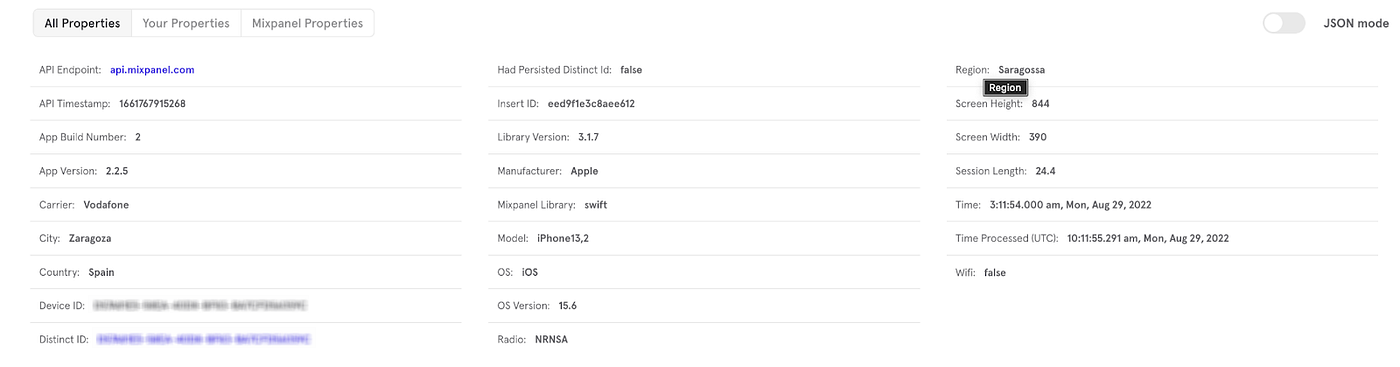
En liknande uppsättning gemensamma användardata kopplas till varje segmentspårningshändelse.
Den här artikeln kommer dock inte att fokusera på spårningsmetoderna eftersom dokumentationen är ganska tydlig och integrationen är ganska enkel.
I det skede när Mixpanel innehåller all information om de spårade åtgärderna, låt oss fundera på hur vi kan återanvända den insamlade datan. Den första idén är att fråga efter dessa data direkt från Mixpanel. Men eftersom Mixpanel inte är utformat för att användas på detta sätt och applikationerna kommer att nå olika hastighetsgränser, måste vi tänka på en annan metod.
För alla typer av beslutssystem måste vi utföra ett par frågor och göra en djupare analys av data. Så det naturliga tillvägagångssättet är att använda datalager, särskilt i de fall där användare för viss dataanalys behöver data från olika datakällor. För detta ändamål tillåter Mixpanel Export Data API export av rådata antingen manuellt eller via pipeline.
För att fortsätta, låt oss förklara hur man konfigurerar Mixpanel-pipelines för extraktion av rådata till AWS S3-bucket.
Innan pipelines skapas är det nödvändigt att skapa en S3-bucket som tar emot och lagrar exporterad rådata och ger Mixpanel de nödvändiga behörigheterna att skriva till bucketen. Detaljer om hur man skapar S3-buckets och behörigheter finns på den här sidan .
Begäranden om att skapa pipelines kan genereras och köras via den här sidan .
De flesta egenskaperna i processen att skapa pipelines är intuitiva och välbeskrivna och kan väljas baserat på dina behov. En viktig anmärkning i denna process är att ställa in parametern ` use_glue` till ` false` .
Orsakerna till detta kommer att förklaras senare i avsnittet om datatransformation.
Ett förslag är också att använda schematypen ` multischema` och aktivera laddning av varje händelsetyp i dess egen dedikerade databastabell. Detta ger bättre strukturering och enklare dataåtkomst.
I vårt användningsfall kommer Mixpanel-data att finnas inom:
Segment kan vara den huvudsakliga eller ytterligare källan till rådata som ska användas i dataanalys. Segment erbjuder också extraktion av rådata till AWS S3-bucket. Konfigurationen av exportpipelinen är enklare än Mixpanel, men dataformat som lagras i S3-bucket är svårare att bearbeta. Detta kommer att förklaras i detalj i nästa avsnitt.
I vårt användningsfall kommer vi att använda samma S3-bucket för att lagra rådata för segment, så samma uppsättning AWS-behörigheter och roller kan användas för konfiguration av exportbuckets.
Exportera från segment är ett enkelt val av ny destination från katalogen (som visas på bilden nedan).
och manuell inmatning av anslutningsinställningar (AWS-region, bucketnamn och IAM-roll-ARN).
I detta fall lagras segmentdata inom
Segmentet har inget alternativ för export av flera scheman och alla spårade händelser exporteras till samma mapp, vilket gör databehandlingen mer komplex.
Data som lagras i S3-bucket är rådata och är inte användbar för tillfället. För att göra den läsbar måste vi strukturera den och omvandla den till ett läsbart format.
För detta ändamål kommer vi att använda AWS Glue som kan tolkas som en dataintegrationstjänst. Glue Data Catalog är faktiskt utformad för att strukturera användardata och den beter sig som en NoSQL-databas med registrerad databas och tabeller. Varje tabell beskrivs av ett schema och refererar till en sökväg till en S3-bucket där data lagras.
Låt oss förklara varför AWS Glue-konfigurationen bör göras manuellt och varför vi inte bör aktivera ` use_glue` i processen att skapa en pipeline, som nämnts i föregående avsnitt.
Exporterade Mixpanel-data som lagras i en S3-bucket är uppdelade efter datum för de spårade händelserna, så till exempel kommer alla ”follow”-händelser som spårades den 1 augusti 2022 att finnas i
s3://…/company_follow_action/2022/08/01/<fileName>.json.gz.
Om ` use_glue` är satt till ` true` under skapandet av pipeline och Mixpanel konfigurerar Glue Data Catalog, skapar Mixpanel en databas, tabell med schema och länk till huvudhändelsekatalogen ( s3://…/company_follow_action ) utan någon partitionsnyckel för data. Senare, med denna metod, kan inget verktyg som behöver åtkomst leta efter den exakta datamängden, eftersom det inte finns någon partition eller struktur associerad med den.
Manuell konfiguration på Glue Data Catalog tillåter datapartitionering. En partition där en post finns symboliseras av partitionsnyckeln inuti varje post i tabellen.
Som ett första steg i konfigurationsprocessen är det nödvändigt att konfigurera AWS Glue Crawlers som är arbetare som ansvarar för att bläddra i katalogen och alla underkataloger med målet att upptäcka hur data är strukturerad och sedan skapa en datakatalogtabell med sökvägar och scheman enligt lagrad rådata.
Baserat på pipeline-konfigurationen kan det vara dagligen/timvis. Glue Crawlers kan schemaläggas att köras dagligen eller timvis. Enligt Mixpanel- och Segment-dokumentationen kan båda källorna exportera data flera gånger inom samma katalog, så det är nödvändigt att konfigurera Glue Crawler att crawla alla undermappar vid varje körning.
Rekommendationen är att skapa separata crawlers för varje tacked event och varje eventmapp inom S3-bucket. I Mixpanel-fallet med multischema konfigurerat kommer crawlern att konfigureras för mappen company_follow_event , medan det för Segment-fallet är nödvändigt att skapa separata crawlers för varje källtyp (Android, iOS, Web, etc.).
När AWS Glue är konfigurerat och data är strukturerade, förenklas sättet att komma åt dessa data. Det första steget blir att ansluta till Redshift-klustret.
Hela processen för klusterkonfiguration och åtkomst till externa data förklaras i AWS-dokumentationen. Följande instruktioner är en översikt över processen för korrekt Redshift-konfiguration:
CREATE EXTERNAL SCHEMA schema_name FROM DATA CATALOG
DATABASE ‘vald-glue-databasnamn’ // definieras när du konfigurerade Glue
IAM_ROLE ‘skapad-roll-arn’ // detta är ARN-koden för rollen med åtkomst till Glue och S3
CREATE EXTERNAL DATABASE IF NOT EXISTS;
Denna anslutning ska bara skapas en gång. Konfigurerade pipelines exporterar data automatiskt till S3-bucketen och Redshift kommer automatiskt att ha åtkomst till alla nya data och schemaändringar. Det betyder att vi kan skriva vilken fråga som helst för att extrahera en specifik datamängd.
För att få information om företagets uppföljningsåtgärder från Mixpanel-data är det möjligt att skriva en enkel fråga:
SELECT companyid, distict_id, mp_os, mp_country_code, mp_processing_time as time
FROM mixpanel.mp_company_follow_actions;
För att komma åt samma datamängd från segmentdatauppsättningen kommer frågan att inkludera åtkomst till kapslade egenskaper och villkor som inkluderar val av specifik spårningshändelse efter namn:
SELECT s.properties.companyid AS companyid, s.userId, s.context.os.name AS os, s.context.ip, s.timestamp AS time
FROM segment.sg_android_source s
WHERE s.event = ‘company_follow_action’;
Det vi kan notera med den här metoden är en ganska långsam frågekörning, särskilt i fall där det är nödvändigt att göra dataextraktion som inkluderar en kombination av tabeller och olika aggregeringar. För att förbättra prestandan är det möjligt att introducera Redshift-materialiserade vyer som kommer att behandlas som ögonblicksbilder av extraherade datamängder som behövs för dataanalyser.
Låt oss säga att vi måste producera följande uppsättning rapporter:
Frågor som visas ovan innehåller all nödvändig information för den här typen av rapporter och i det här fallet är det möjligt att skapa en materialiserad vy som håller all information uppdaterad med extraherad data som finns i S3-bucketen.
CREATE MATERIALIZED VIEW sg_followers_view
BACKUP YES
AS
SELECT s.properties.companyid as companyid, s.userId, s.context.os.name, s.context.ip, s.timestamp as time
FROM segment.sg_android_source s
WHERE s.event = ‘company_follow_action’;
Den skapade materialiserade vyn återspeglar den aktuella datamängden som exporterats till S3-bucket. För att tillhandahålla kontinuerliga uppdateringar och inkludera ny data som kommer till S3-bucket är det nödvändigt att schemalägga uppdateringen av den materialiserade vyn. Detta kan uppnås genom att använda Redshift-schemaläggaren som kör följande fråga:
REFRESH MATERIALIZED VIEW sg_followers_view;Export av dokumentation per Mixpanel och segment sker en gång i timmen, så uppdateringen av den materialiserade vyn bör schemaläggas varje timme.
Den skapade materialiserade vyn kan behandlas som vilken Redshift-databastabell som helst och frågas på samma sätt. I vårt fall kan det totala antalet företagsföljare extraheras som:
SELECT companyid, count(distinct userid)
FROM sg_followers_view
GROUP BY companyid
Dagliga och platsfördelningar av företagets följare kan uppnås med aggregering per tid och plats. Alla dessa operationer är fortfarande enkla aggregeringar. Oftare är det nödvändigt att utföra komplex aggregering på en mycket stor datamängd och i detta fall föreslås det att man gör den andra nivån av dataextraktion som kan skapa aggregerade datatabeller som innehåller aggregerade värden valda från materialiserade vyer.
Till exempel
CREATE TABLE data.company_aggregated_followers_table
AS
SELECT companyid, to_date(cast(time as timestamp), ‘YYYY-MM-DD’) as formattedDate, count(userid) as totalFollowers
FROM sg_followers_view
GROUP BY companyId, formattedDate
Det är dock nödvändigt att tillhandahålla uppdateringar av dessa aggregerade tabeller och detta kan också uppnås genom att köra en uppsättning frågor i Redshift-schemaläggaren:
CREATE TEMP TABLE company_aggregated_followers_stage (like data.company_aggregated_followers_table);
INSERT INTO
 company_aggregated_followers_stage
SELECT
 companyId,
 to_date(cast(time as timestamp), ‘YYYY-MM-DD’) as formattedDate,
 count(userid) as totalFollowers
FROM
 public.sg_followers_view
WHERE
 formattedDate BETWEEN to_date(dateadd(day, -1, current_date), ‘YYYY-MM-DD’)
 AND current_date
GROUP BY
 companyId,
 formattedDate;
DELETE FROM
 data.company_aggregated_followers_table using company_aggregated_followers_stage
WHERE
 data.company_aggregated_followers_table.companyid = company_aggregated_followers_stage.companyid
AND company_aggregated_followers_table.formattedDate = company_aggregated_followers_stage.formattedDate;
INSERT INTO
 data.company_aggregated_followers_table
SELECT *
FROM
company_aggregated_followers_stage;
DROP TABLE company_aggregated_followers_stage;Rapporter och analyser är en mardröm för de flesta utvecklare, medan de för kunder och intressenter är hjärtat i alla företag och deras behov av olika typer av information förändras dagligen. Detta kan klassificeras som den främsta anledningen till att det är nödvändigt att ha tillgång till all data på ett ställe.
Målet med den här artikeln var att ge idéer om hur man kan samla all data från olika källor på ett ställe. Källor och slutlig plats kan väljas på olika sätt, men principerna är desamma. Dessutom kan olika typer av optimering och prestandaförbättringar tillämpas. Allt beror på dina behov och vilken teknikstack din verksamhet är baserad på.
