De flesta AI-produkter faller offer för sin arkitektur innan de slås ut av konkurrenterna.
Föreställ dig följande: ett fintech-startup företag utvecklar ett verkligt imponerande verktyg för dokumentgranskning. Det är snabbare än manuell granskning, prisvärt och tekniskt väl genomtänkt. De lägger månader på att få till stånd ett proof of concept med en storbank – demonstrationer, tekniska utvärderingar och att vinna stöd från intressenter i hela organisationen. Sedan hamnar affären hos inköpsavdelningen. Bankens informationssäkerhetspolicy förbjuder kategoriskt att kundernas finansiella data kommer i kontakt med någon extern API-ändpunkt. Inga undantag för stark kryptering. Inga undantag för anonymisering. Policyn finns eftersom tillsynsmyndigheterna förväntar sig att den ska finnas.
Affären går i stöpet. Inte för att produkten misslyckades, utan för att den utformades utifrån ett antagande som kunden aldrig skulle acceptera.
Denna förutsättning – att inferensen sker i molnet – är inbyggd i det standardförfarande som används vid utvecklingen av de flesta AI-produkter idag. Och det skapar en begränsning som är osynlig tills den blir kostsam.
LLM-modeller som körs lokalt vänder upp och ner på det antagandet. Det handlar om stora språkmodeller som utför inferens lokalt, direkt på hårdvaran, utan att vidarebefordra förfrågningar till en fjärrserver. Ingen API-fördröjning, inga molnkostnader per förfrågan och inga data lämnar enheten. Modellen följer med användaren.
Inferens på enheten förvandlar AI från en nätbaserad tjänst till en hållbar och bärbar funktion. Det är inte bara en teknisk finess – det är en affärsmässig möjlighet.
Denna omställning är nu genomförbar i produktionsskala, driven av tre samverkande faktorer:
Den tekniska utmaningen handlar inte om huruvida stora språkmodeller (LLM) på enheten fungerar. Det gör de. Utmaningen ligger i att hitta rätt balans mellan modellens kapacitet, minnesbehov, inferenshastighet och komplexiteten vid driftsättning – och att göra dessa avvägningar medvetet istället för att upptäcka dem först i produktionsmiljön.
Den här guiden går igenom dessa beslut: hur man avgör var inferens på enheten passar in i din produkt, hur man väljer och dimensionerar en modell, hur man utformar arkitekturen för hybridrouting och hur man ser till att varje routingbeslut går att granska. Oavsett om du utvärderar detta för ett specifikt användningsfall eller utarbetar en plan för driftsättning är målet att ge dig beslutsramar som du kan agera utifrån omedelbart.
Här är det bekymmersamma mönstret: de branscher som har de största budgetarna för AI är just de branscher som omfattas av de strängaste kraven på datalagring, datasuveränitet och datasäkerhet.
Dessa organisationer är varken krävande kunder eller undantagsfall. De är själva kunderna – de som skriver ut de största checkarna. Och de har ett krav som inte går att förhandla bort: uppgifterna får inte lämna den kontrollerade miljön.
Molnbaserad inferens är den enklaste vägen under utvecklingsfasen. Det går snabbt att ta fram prototyper, det är enkelt att göra iterationer och det finns inga hårdvarubegränsningar. Därför utvecklar teamen sina lösningar för molnet, levererar dem till molnet och go dem go marknaden via molnet. Denna förutsättning cementeras i arkitekturen. Arkitekturen blir ett försäljningshinder som ingen lägger märke till förrän en affär går i stöpet i upphandlingsfasen.
De organisationer som är villiga att betala mest för AI-funktioner är ofta just de vars regel- och säkerhetskrav gör det arkitektoniskt omöjligt att sälja en lösning som enbart bygger på inferens i molnet till dem.
Att driva stora språkmodeller (LLM) lokalt på enheter och i egna lokaler är inte bara en teknisk nischfråga. Det är en förutsättning för att ta sig in på det marknadssegment där betalningsviljan är som störst. Att förstå hur man bygger upp sådana lösningar – och vilken komplexitet det faktiskt medför – håller snabbt på att bli en central affärskompetens.
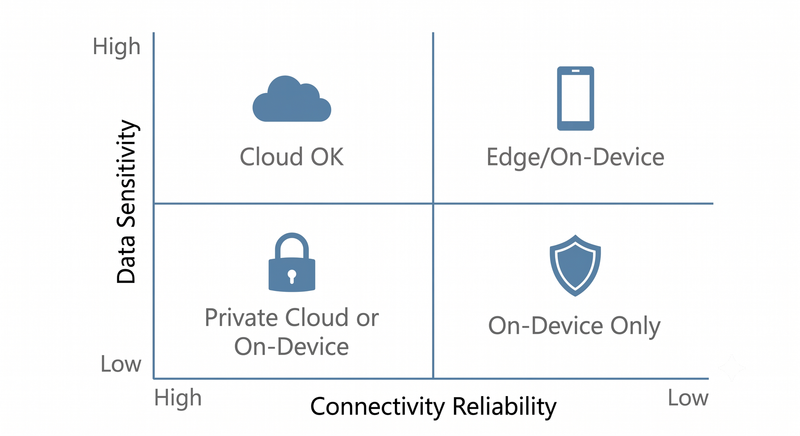
Innan du utvärderar modeller eller jämför latens, bör du ställa dig en ärlig fråga: var kommer din produkt faktiskt att användas, och vilken typ av data kommer den att hantera?
Två faktorer – datakänslighet och anslutningssäkerhet – avgör i stort sett allt när det gäller din driftsarkitektur. Inte vilken molnleverantör du föredrar. Inte heller hur väl ditt teknikteam behärskar en viss teknikstack. Utan den miljö som dina användare faktiskt arbetar i.
| Hög anslutningskapacitet | Dålig anslutning | |
|---|---|---|
| Låg datakänslighet | ☁️ Cloud fungerar. Släpp det. | 📱 På enheten eller i edge-miljön – uppkopplingen är den begränsande faktorn. |
| Hög datakänslighet | 🔒 Lokalt eller i ett privat moln — efterlevnad är den avgörande faktorn. | 🏗️ Direkt på enheten, punkt. Det finns inget alternativ. |
Zon 1 — Låg känslighet, pålitlig uppkoppling. En receptapp för konsumenter med stabil internetuppkoppling. Molnbaserad inferens är kostnadseffektiv och enkel. Att lägga till komplexitet i enheten ger inga fördelar i detta fall.
Zon 2 – Låg känslighet, opålitlig uppkoppling. En fältapp för tekniker inom energibranschen. Molnbaserad inferens täcker de flesta arbetsflöden – tills en tekniker går in i en RF-skärmad transformatorstation. AI-assistenten slutar fungera just vid det arbete där den skulle ge störst nytta.
Zon 3 — Hög säkerhet, tillförlitlig anslutning. En plattform för granskning av juridiska dokument som hanterar konfidentiell kommunikation. Nätverket fungerar som det ska. Att vidarebefordra kunddata via ett tredjeparts-API för inferens gör det däremot inte.
Zon 4 — Hög känslighet, opålitlig nätverksanslutning. Ett mobilt diagnostiskt verktyg för vårdpersonal vid vårdinrättningar på landsbygden. Patientdata får inte lämna enheten, och nätverket är opålitligt. En arkitektur där allt sker på enheten är den enda som fungerar.
Det vanligaste arkitektoniska misstaget är inte att välja fel driftsättningsmodell. Det är att välja en driftsättningsmodell innan man noggrant har kartlagt var produkten ska användas och av vem.
De flesta produkter passar inte helt in i ett enda kvadrant – och det är helt okej. Övningen fungerar ändå eftersom den tvingar dig att identifiera de användare som är viktigast för dig, inte bara de genomsnittliga. Inspektören vid transformatorstationen kanske inte representerar majoriteten av din användarbas. Men det kan vara just de som är anledningen till att produkten finns.
Kryptering är en teknisk egenskap. Det är inte ett rättsligt försvar. Tillsynsmyndigheter och domstolar frågar inte hur uppgifterna har överförts – de frågar om det har skett.
Denna skillnad brukar komma fram först i ett sent skede av försäljningsprocessen. Efter att ditt team har fastställt omfattningen av integrationen. Efter att teknikavdelningen har byggt upp processen. Efter att demonstrationen har mottagits väl av kundens produktteam. Sedan granskar den juridiska avdelningen arkitekturen, och affären går i stå. De redan gjorda kostnaderna är verkliga.
Det som utgör ett brott mot efterlevnadskraven är när data lämnar enheten. Allt som sker därefter – TLS, signerade DPA:er, SOC 2-certifieringar – blir av underordnad betydelse så snart den gränsen överskrids.
Ta programvara för stöd vid rättstvister som exempel. Ett verktyg som skickar förfrågningar om målstrategi via en tredjeparts LLM-ändpunkt – även om det finns vattentäta avtalsmässiga skyddsåtgärder – ger upphov till ett hållbart argument för att upphäva advokatsekretessen. Den juridiska frågan är inte om leverantören är pålitlig. Frågan är om konfidentiell kommunikation har lämnats ut till en tredje part. Det har den. Uppgifterna har överförts. Den överföringen är den avgörande händelsen.
Samma logik gäller inom alla reglerade branscher:
Om svaret på fråga tre är ”vi anropar ett externt API”, har du ingen strategi för regelefterlevnad. Du har ett problem med regelefterlevnaden som ännu inte har upptäckts.
I dessa sammanhang handlar inferens på enheten inte om prestandaoptimering. Det är den enda arkitekturen som helt eliminerar behovet av dataöverföring. Modellen körs lokalt. Data stannar lokalt. Det finns inget som en tillsynsmyndighet kan utvärdera eller som en domstol kan granska.
Det är här team oftast go . De betraktar modellvalet som ett forskningsproblem – de jämför perplexitetsvärden, jämför MMLU-resultat och jagar den bäst presterande modellen med öppen viktning som finns tillgänglig. Sedan släpper de en produkt som inte passar på målenheten, som inte förstår ämnesområdet och som inte imponerar på någon som spelar någon roll.
Modellvalet är en del av produktspecifikationen. Konstruktionen utgår från produktens tydlighet, inte tvärtom.
Tänk dig ett verktyg för kundsupport hos ett medelstort detaljhandelsvarumärke. En allmän 7B-modell låter lockande i demonstrationerna – den är tydlig, bred och hanterar specialfall smidigt. Men den misslyckas konsekvent med den specifika logiken kring returpolicyn, identifierar felaktigt SKU:er och har svårt att tolka de förkortningar som riktiga supportmedarbetare använder dagligen. En finjusterad 2B-modell, tränad på sex månaders lösta supportärenden, överträffar den i alla mätvärden som faktiskt är viktiga för verksamheten. Och den körs på Android-enheter i mellanklassen med gott om minne.
Större är inte bättre. Relevant är bättre.
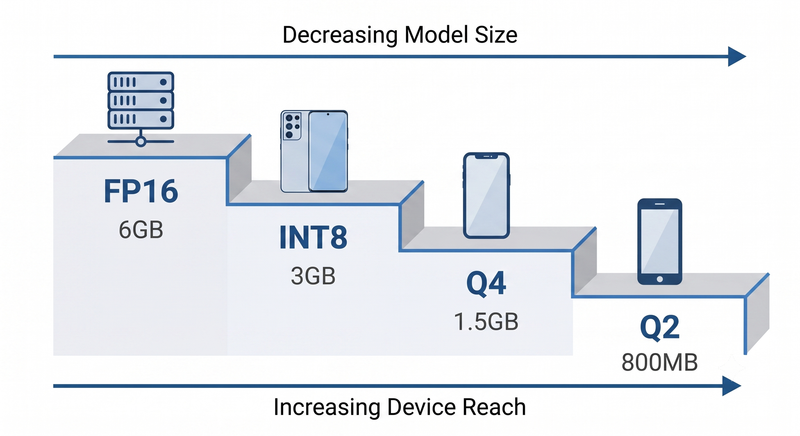
Se inte kvantisering som något som försämrar kvaliteten, utan som en kurva som visar enhetens räckvidd. Varje steg nedåt gör produkten tillgänglig för en bredare hårdvarubas.
| Format | ~Storlek (modell 3B) | Bedömning av driftsättningen |
|---|---|---|
| FP16 | ~6 GB | Opraktiskt för de flesta mobila enheter |
| INT8 | ~3 GB | Begränsat — endast flaggskeppsmodeller |
| Q4 | ~1,5 GB | Lämplig — omfattande täckning av enheter i mellanklassen |
| Q2 | ~800 MB | Aggressiv — stor räckvidd, kvaliteten beror på uppgiften |
Den tekniska frågan formuleras helt på nytt: vad är den lägsta kvalitetströskeln för just denna uppgift, och vad är den maximala räckvidden för enheten som kan uppnås vid den tröskeln?
När det gäller verktyget för detaljhandelsstöd kan Q4 bibehålla tillräcklig domänprecision för att vara omöjlig att skilja från FP16 i de uppgifter som är avgörande. För en assistent inom medicinsk dokumentation kan INT8 vara den lägsta nivån som man inte go.
VRAM-taket är en produktbegränsning, inte en fotnot om hårdvaran. Om din målenhet har 4 GB delat minne och din modell kräver 6 GB, har du ingen driftslösning – du har en prototyp. Fastställ din enhets lägsta minneskrav innan du slutgiltigt bestämmer dig för vilken modell du ska använda.
Produktkraven sätter en lägsta kvalitetsnivå. Kvantiseringsstegen avgör hur långt du kan nå. Arbeta i den ordningen.
Här är ett fel som utvecklas så långsamt att ingen märker det förrän det har blivit kostsamt.
Ett produktteam lanserar en molnbaserad AI-funktion. Sex månader senare behöver de en offlineversion. Istället för att se över den ursprungliga arkitekturen bygger de ett parallellt system – separat kodbas, separat promptutveckling, separat QA-pipeline. Det känns pragmatiskt just då.
Vid den tolfte månaden når en buggfix som tillämpats på molnvägen aldrig offlinevägen. Produkten beter sig olika beroende på uppkopplingen, på sätt som ingen planerat, ingen dokumenterat och ingen helt kan förklara. Den slutliga omskrivningen för konsolideringen kunde ha undvikits genom ett enda beslut om gränssnittet redan från början.
Mönstret är enkelt. Tre delar:
ModelRepository gränssnitt — definierar vad AI-kapaciteten innebär gör, utan att ta ställning till var den gårModelRepositoryFactory — den enda platsen där routningslogiken finns// The contract (pseudocode)
interface ModelRepository {
generateResponse(prompt: string): Response
summarize(content: string): Summary
}
// Cloud implementation
class CloudModelRepository implements ModelRepository { ... }
// On-device implementation
class OnDeviceModelRepository implements ModelRepository { ... }
// The only place routing decisions are made
class ModelRepositoryFactory {
static create(context: DeviceContext): ModelRepository {
if (context.isOnline && context.taskRequiresCloud) {
return new CloudModelRepository()
}
return new OnDeviceModelRepository()
}
}
I resten av applikationen ställs aldrig frågan där slutsatsen dras. Den anropar ModelRepository och får ett svar. Det är allt.
De ModelRepositoryFactory är den enda platsen där routningslogiken finns – och det är just det som är poängen. När du behöver undersöka varför en viss användare fick ett svar från molnet istället för ett lokalt svar, behöver du bara titta på en enda plats.Detta är viktigt för felsökning, för granskningar av efterlevnad och för nästa utvecklare som tar över kodbasen. Routinglogik som är utspridd över olika funktionsfiler utgör en underhållsrisk. Routinglogik som är centraliserad i en fabrik är en policy som du kan läsa, testa och ändra på under en eftermiddag.
Arkitekturen stöder inte bara inferens på enheten – den gör att införandet av den blir en tilläggsfunktion snarare än en störande faktor.
Inom reglerade branscher är routningslogiken – beslutet om när inferensen ska köras lokalt respektive i molnet – inte bara en teknisk fråga. Det är en del av efterlevnaden.
”Systemet fattade beslutet lokalt” räcker inte för en efterlevnadsansvarig. ”Systemet vidarebefordrade lokalt eftersom flaggan för känsliga uppgifter var aktiverad och enheten var offline, i enlighet med policyversion 2.3, kl. 14:32 UTC” däremot.
Tänk dig en vårdorganisation som inför en AI-baserad dokumentationsassistent. Deras team för regelefterlevnad vill inte bara att personuppgifter (PHI) ska behandlas lokalt på enheten. De vill ha en tidsstämplad logg som bevisar att varje förfrågan som innehåller personuppgifter (PHI) har dirigerats lokalt, tillsammans med den specifika policyregeln som låg till grund för beslutet. Dirigeringslagret är inte bara en del av infrastrukturen – det är bevis.
Beslut om vidarebefordran bör vara tydliga, loggas och kunna konfigureras utan att vara bundna till en release-cykel. Bristande insyn i vidarebefordringen utgör en risk i alla reglerade sammanhang.
Betrakta dessa som en rangordnad hierarki. Regler med högre prioritet har alltid företräde framför regler med lägre prioritet:
| Kriterium | Moln | Lokalt |
|---|---|---|
| Fördröjning | Variabel, nätverksberoende | Konsekvent, vanligtvis under 100 ms |
| Kostnad vid storskalig produktion | Per token, sammansättningar bildas snabbt | Fast avskrivning på materiella anläggningstillgångar |
En LLM på enheten är en stor språkmodell som utför inferens lokalt på själva enheten, utan att vidarebefordra förfrågningar till en fjärrserver eller ett externt API. Inga data lämnar hårdvaran, inga molnkostnader ackumuleras per förfrågan, och modellen fungerar oavsett om enheten har nätverksanslutning eller inte. Modellen följer med användaren – vilket förvandlar AI från en nätverksbaserad tjänst till en hållbar, bärbar funktion.
LLM-modeller som körs lokalt på enheten är viktiga för företagsförsäljningen eftersom de mest lönsamma kunderna – sjukhus, advokatbyråer, försvarsleverantörer och finansinstitut – omfattas av krav på datalagring och säkerhet som gör det arkitektoniskt omöjligt att sälja lösningar som enbart bygger på inferens i molnet till dem. En produkt som uteslutande bygger på inferens i molnet har ett osynligt tak som först blir synligt när en affär går i stöpet under upphandlingsprocessen. De organisationer som betalar mest för AI är ofta de vars policyer kategoriskt förbjuder att kunddata kommer i kontakt med en extern API-ändpunkt.
Kvantisering minskar en modells minnesbehov genom att vikten representeras med lägre numerisk precision – vilket gör att en kraftfull modell kan krympa från tiotals gigabyte till en storlek som ryms på vanlig konsumenthårdvara. En modell med 3 miljarder parametrar minskar från ungefär 6 GB vid FP16 till cirka 1,5 GB vid Q4, vilket är skillnaden mellan ”endast flaggskeppsmodeller” och ”bred täckning i mellanklassen”. Den tekniska frågan handlar inte om hur mycket kvalitet du är villig att offra – utan om vad den lägsta kvalitetströskeln är för just din uppgift, och vilken enhetstäckning som är möjlig vid den tröskeln.
Definiera en enskild ModelRepository ett gränssnitt som specificerar vad AI-funktionen gör, och sedan bygga två konkreta implementationer – en för molnet och en för enheten – bakom en fabrik som hanterar all routningslogik. Resten av applikationen anropar gränssnittet och får ett svar; den frågar aldrig var inferensen ägde rum. Att centralisera routningen i en enda fabrik innebär att du kan granska, testa och ändra beslutslogiken på en eftermiddag istället för att behöva leta igenom utspridda funktionsfiler.
Använd molnbaserad inferens när datakänsligheten är låg, anslutningen är tillförlitlig och uppgiften verkligen överstiger vad en komprimerad lokal modell klarar av – sammanfattning av långa sammanhang, komplexa resonemang i flera steg eller arbetsbelastningar där skillnader i modellkvalitet är mätbara och har betydelse för affärsresultatet. Molninferens är också det rätta standardvalet under tidig prototyputveckling, när iterationstakten är viktigare än driftsbegränsningar. Misstaget är inte att välja molnet – det är att välja molnet innan man noggrant har kartlagt var produkten kommer att användas och vilka data den kommer att hantera.
Kryptering är en teknisk egenskap, inte ett rättsligt försvar – tillsynsmyndigheter och domstolar undersöker om data har lämnat enheten, inte hur den skyddades under överföringen. Ett verktyg för stöd vid rättstvister som dirigerar förfrågningar om fallstrategi via en tredjeparts LLM-ändpunkt skapar ett hållbart argument för att upphäva advokatsekretessen, oavsett leverantörens SOC 2-certifiering eller avtalsenliga skyddsåtgärder. Den händelse som avgör efterlevnaden är själva överföringen. Inferens på enheten eliminerar den händelsen helt; allt annat sker efter den.
Inferens på enheten innebär att modellen körs på slutanvändarens hårdvara – en telefon, bärbar dator eller ett inbyggt system – utan att det krävs någon nätverksanslutning. Edge-distribution avser vanligtvis inferens som körs på närliggande infrastruktur (en lokal server, gateway-enhet eller regional nod), vilket minskar latensen jämfört med molnet men ändå innebär ett nätverkshopp och en separat beräkningsmiljö. För användningsfall där data inte alls får lämna en kontrollerad miljö är inferens på enheten den enda arkitekturen som helt eliminerar överföringen.
Skapa en routningslogik som loggar den specifika policyregeln, flaggan för datakänslighet, anslutningsstatus och tidsstämpel bakom varje beslut – inte bara resultatet. ”Systemet dirigerade lokalt” kommer inte att tillfredsställa en efterlevnadsansvarig; ”systemet dirigerade lokalt eftersom känslighetsflaggan för PHI var aktiverad och enheten var offline, enligt policyversion 2.3, kl. 14:32 UTC” kommer däremot att göra det. Behandla dirigeringslagret som en efterlevnadsartiklar, inte som infrastrukturens rörsystem, och gör det konfigurerbart utan att det kräver en release-cykel.
