Jag tror att det här är mitt allra första blogginlägg, eftersom jag inte kan hitta något annat jag har skrivit på nätet. Jag har nog glömt bort det. Så, lite om mig själv. De som känner mig vet att jag brukar gnälla på allt, framför allt på folk som inte sköter sitt jobb, så det kommer jag att fortsätta med även här på nätet. Ibland kommer jag att skriva en hjälpsam artikel med en handledning om något, men mestadels kommer jag att skriva om mina erfarenheter av systemdrift/SRE, eller som man säger idag, DevOps (Gud, vad jag hatar den här ”titeln”). Det jag kommer att skriva om i den här artikeln är bara toppen av isberget av allt jag har sett genom åren.
Det finns mer att berätta – jag skulle nog kunna skriva en hel bok, men jag är inte särskilt bra på att skriva, som du kommer att se nedan.
När det gäller att skapa en ny tjänst finns det inget bättre tillfälle att utforma den precis som du vill, eftersom du tidigare har arbetat med något annat som helt enkelt inte kändes rätt – eller där du ville ge upp, kräkas eller slå sönder din bärbara dator med en hammare när du tittade på koden.
Så du börjar alltså skapa något nytt för att underlätta ditt arbete, men det är just här som de flesta utvecklare skapar ett stort problem (hälsning) för alla andra. De tenderar att bygga upp sin perfekta miljö, oftast inriktad på utveckling, och glömmer under tiden bort att den här nya tjänsten kan hamna i produktion. Konfigurationen är oftast dåligt dokumenterad, knappt automatiserad och för att få den att fungera krävs det ett getoffer till vad du nu än tror på. Din MacBook Pro kommer inte att skickas till AWS eller Google Cloud för att hantera trafik, så frasen ”Det fungerar på min maskin” funkar inte för mig. När jag hämtar repositoriet med din tjänst vill jag köra ett enda kommando och vara klar med det. Om den körs i en container, jättebra. Om inte, är det bäst att du har ett startskript som konfigurerar allt. Att läsa igenom README.md-filer är slöseri med min tid – tid som jag kunde ha använt till något bättre än att se dig uppfinna ännu ett sätt att konfigurera en Node-, GoLang- eller Scala/Java-tjänst med onödiga manuella steg.
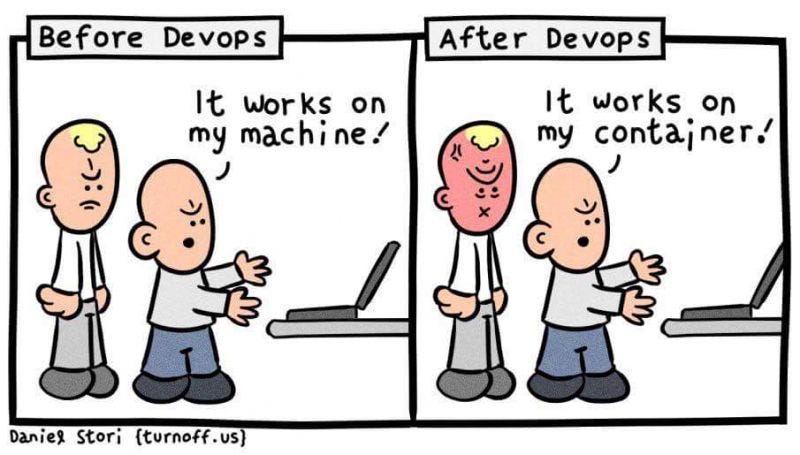
Så när du börjar skriva din nya tjänst, tänk först på produktionsmiljön och sedan på din utvecklingsmiljö. Läs om”12-faktor-appen”ellerutveckling av molnbaserade applikationer, och var inte den där typen.
En av principerna vid utformningen av en modern tjänst är att separera konfigurationen från själva tjänsten. Som standard görs detta antingen genom att använda miljövariabler vid start av tjänsten eller genom att använda någon form av process för att tillhandahålla en konfigurationsfil – vars innehåll vanligtvis är hemligt – till tjänsten. Det förstnämnda föredras oftast på grund av sin enkelhet, men om någon insisterar på det senare finns det många sätt att åstadkomma detta. Eftersom jag dock alltid har stött på problem med miljövariabler kommer jag att gnälla lite om detta.
Så, till att börja med: hur många variabler är för många? Har du någonsin sett en konfiguration med 300 miljövariabler, där vissa består av en flerradig textvägg? Det har jag. När du bestämmer vad som ska extraheras till en miljövariabel, bestäm då vad som är miljöspecifikt och extrahera just det. Till exempel: du har en S3-bucket med flera mappar för uppladdade/storleksanpassade bilder och du har tre miljöer:
https://images-bucket.s3.something.com/image
https://images-bucket.s3.something.com/thumbnails
https://images-bucket.s3.something.com/avatars
Du behöver inte tre variabler per miljö för detta, utan bara en: bucket-ändpunkten. Om din tjänst är utformad på ett förnuftigt sätt kommer dina miljöer att ha identisk mappstruktur, så den enda variabeln här är den unika bucketen per miljö. Detta blir också viktigt om du använder K8s eller något liknande, där flera miljöer kan ha nästan identisk konfiguration. Tänk dig att du använder docker-compose för din lokala utveckling och har en databasvärd som bara heterdb. Nu kan du ha samma sak i din produktion eller staging, och du kan ange värdnamnet som standard i koden och åsidosätta det vid behov med hjälp av miljövariabler. Detsamma gäller för portnummer. Varför behöver du ha 5432 för Postgres eller 6379 för Redis exponerade som miljövariabler? Det är välkända portar som bör anges som standard i din konfiguration och endast åsidosättas om du av någon anledning behöver att de ska vara annorlunda. Tänk alltså på detta nästa gång du börjar koda en ny tjänst.
För Guds skull, måste planeterna stå i rätt konstellation för att tjänsten ska fungera? Har du inte angett dina biblioteksberoenden korrekt? Det kommer förmodligen att fungera bra under en viss tid, tills någon bestämmer sig för att släppa en ny version av ett av dina beroenden och förstör allt.
En ny utvecklare börjar på företaget, sätter igång med att konfigurera sin dator och klona projekt. Han försöker köra tjänsten för första gången, men den fungerar inte. Beroendena som är installerade på hans dator stämmer inte. Men det fungerar på din dator. Bara för att du inte orkade använda en pakethanterare med låsfiler och aldrig rensar pakethanterarens cache. Att köra byggprocesser inuti containrar är ett sätt att kontrollera om du har låst beroenden korrekt, eftersom allt kommer att byggas från grunden. Om du inte monterar node_modules eller ivy-cachen inuti containern. Gör inte det. Snälla.
Telemetri och loggar?
Tänkte du inte alls på driften under någon del av designprocessen? Jag tänker inte bry mig om att rädda din tjänst när den väl börjar rasa samman i ett brinnande vrak. Utvecklarna bestämde sig för att följa strömmen och köra några nya tjänster på K8s. Toppen, bra för er, ni klättrar uppåt i världen. Men glömde ni att bygga in någon form av telemetri i er tjänst? Jag är ingen spåman som kan förutsäga när din tjänst kommer att krascha, och om den gör det ska jag se till att det är du som vaknar klockan 03.00 för att fixa det. Om du ska köra på K8s är detbara några rader kod som krävs för attexponera mätvärden till Prometheus, och då kan vi göra alla möjliga typer av larm, skalning och omstart när saker och ting go går snett. Eller innan de go går snett. Åh, en sak till:
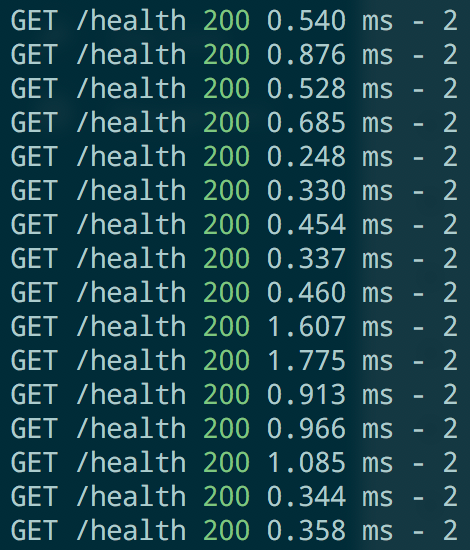
Tycker du att det där ser användbart ut? För mig ser det ut som att du försöker förstöra vår loggningsstack och få mina ögon att blöda när jag felsöker. Det gör förmodligen inte ens kontrollen ordentligt, det returnerar bara 200. Hur som helst behöver du inte logga varje lyckad begäran, du behöver logga när saker go går fel. Och när de go går fel kommer tjänsten ändå att startas om, så händelsen borde berätta för mig varför den misslyckades. Detta gäller allt annat som har med loggning av händelser att göra. Samma sak gäller loggnivåer. Är det någon som fortfarande använder det här? Folk har glömt grunderna. Om du loggar varje förfrågan bara för att, är det som att ha TRACE påslaget hela tiden. Jag har sett tjänster som varken loggar någonting alls, eller som loggar allt. Inget av detta är till någon hjälp och det ser ut som att någon inte tänkte efter när de skrev koden. Använd rätt loggnivåer, folk!
Gör du migreringen av ditt databasschema manuellt? Då gör du fel. Måste du skapa utbyten manuellt i meddelandemellanprogramvaran för att du har slarvat med koden? Fortfarande fel. Om du använder ” go ” enligt mikrotjänstmodellen måste dina mikrotjänster hantera schema- eller datamigreringar. Det finns många verktyg som gör det möjligt, till exempelFlywayellerLiquibase. Om du använderRails finns redan allt på plats. Om du gör allt med containrar och förhoppningsvis använder Kubernetes kan du koppla in dina migreringar vid tjänstens uppstart, så att vid distribution av nya versioner startas en ny container och migreringarna körs i förväg. Eller så kan du hantera schemamigreringarna som engångsjobb. Gör det som passar dig bäst. Gör det bara inte manuellt. Du kommer troligen att glömma hälften av det som behöver göras. Dina produktions- och stagingmiljöer kommer att börja glida isär väldigt snabbt. Något kommer att fungera i produktion men misslyckas totalt i staging. När tjänsten går ner mitt i natten vill du inte behöva leta framrunbooksoch söka efter just den händelsen, för att sedan gå igenom steg för steg go för att återställa driften. Schemamigreringar och automatisering i allmänhet kan kännas skrämmande för många i början. Jag förstår det. Du överlämnar databashanteringen till ett skript som du eller någon annan har skrivit. När din tjänst startar kommer den förmodligen att skapa allt den behöver för att fungera. Det har inte testats ordentligt, eller inte alls. Men det är just det: om det känns jobbigt, gör det oftare – då blir du bättre på det. Du kommer att vänja dig, och senare kommer du att undra hur i helvete du någonsin kunde arbeta utan det.
Det räcker så från mig för tillfället. Om jag har glömt att gnälla om något kommer det nog att bli en del två. Fortsätt gärna att gnälla i kommentarerna, jag är säker på att alla har något att gnälla om. Nu måste jag tillbaka till jobbet, ni vet, med en piska och en sur min.
